Pro版:记忆与质量评测
前面几篇介绍了 Nexus Agent Pro 怎样从文档里找资料、整理内容关系,再给出有出处的回答。真正连续使用起来,还有两件事很影响体验。
一件是聊久了以后,系统能不能接上前面的话。背景刚交代过,后面又得重新说;已经确定的事情,隔几轮还要再解释一遍,使用起来就会很费劲。
另一件是回答的效果到底怎么样。演示时几个问题答得不错,换一份资料、换一种问法,还能不能答到点上?项目增加了新能力,怎样知道它有没有带来进步?
这篇就带小伙伴看看 Pro 版在这两方面做了什么:用会话记忆承接长期交流,用质量评测检查真实回答。
会话记忆:减少反复交代背景
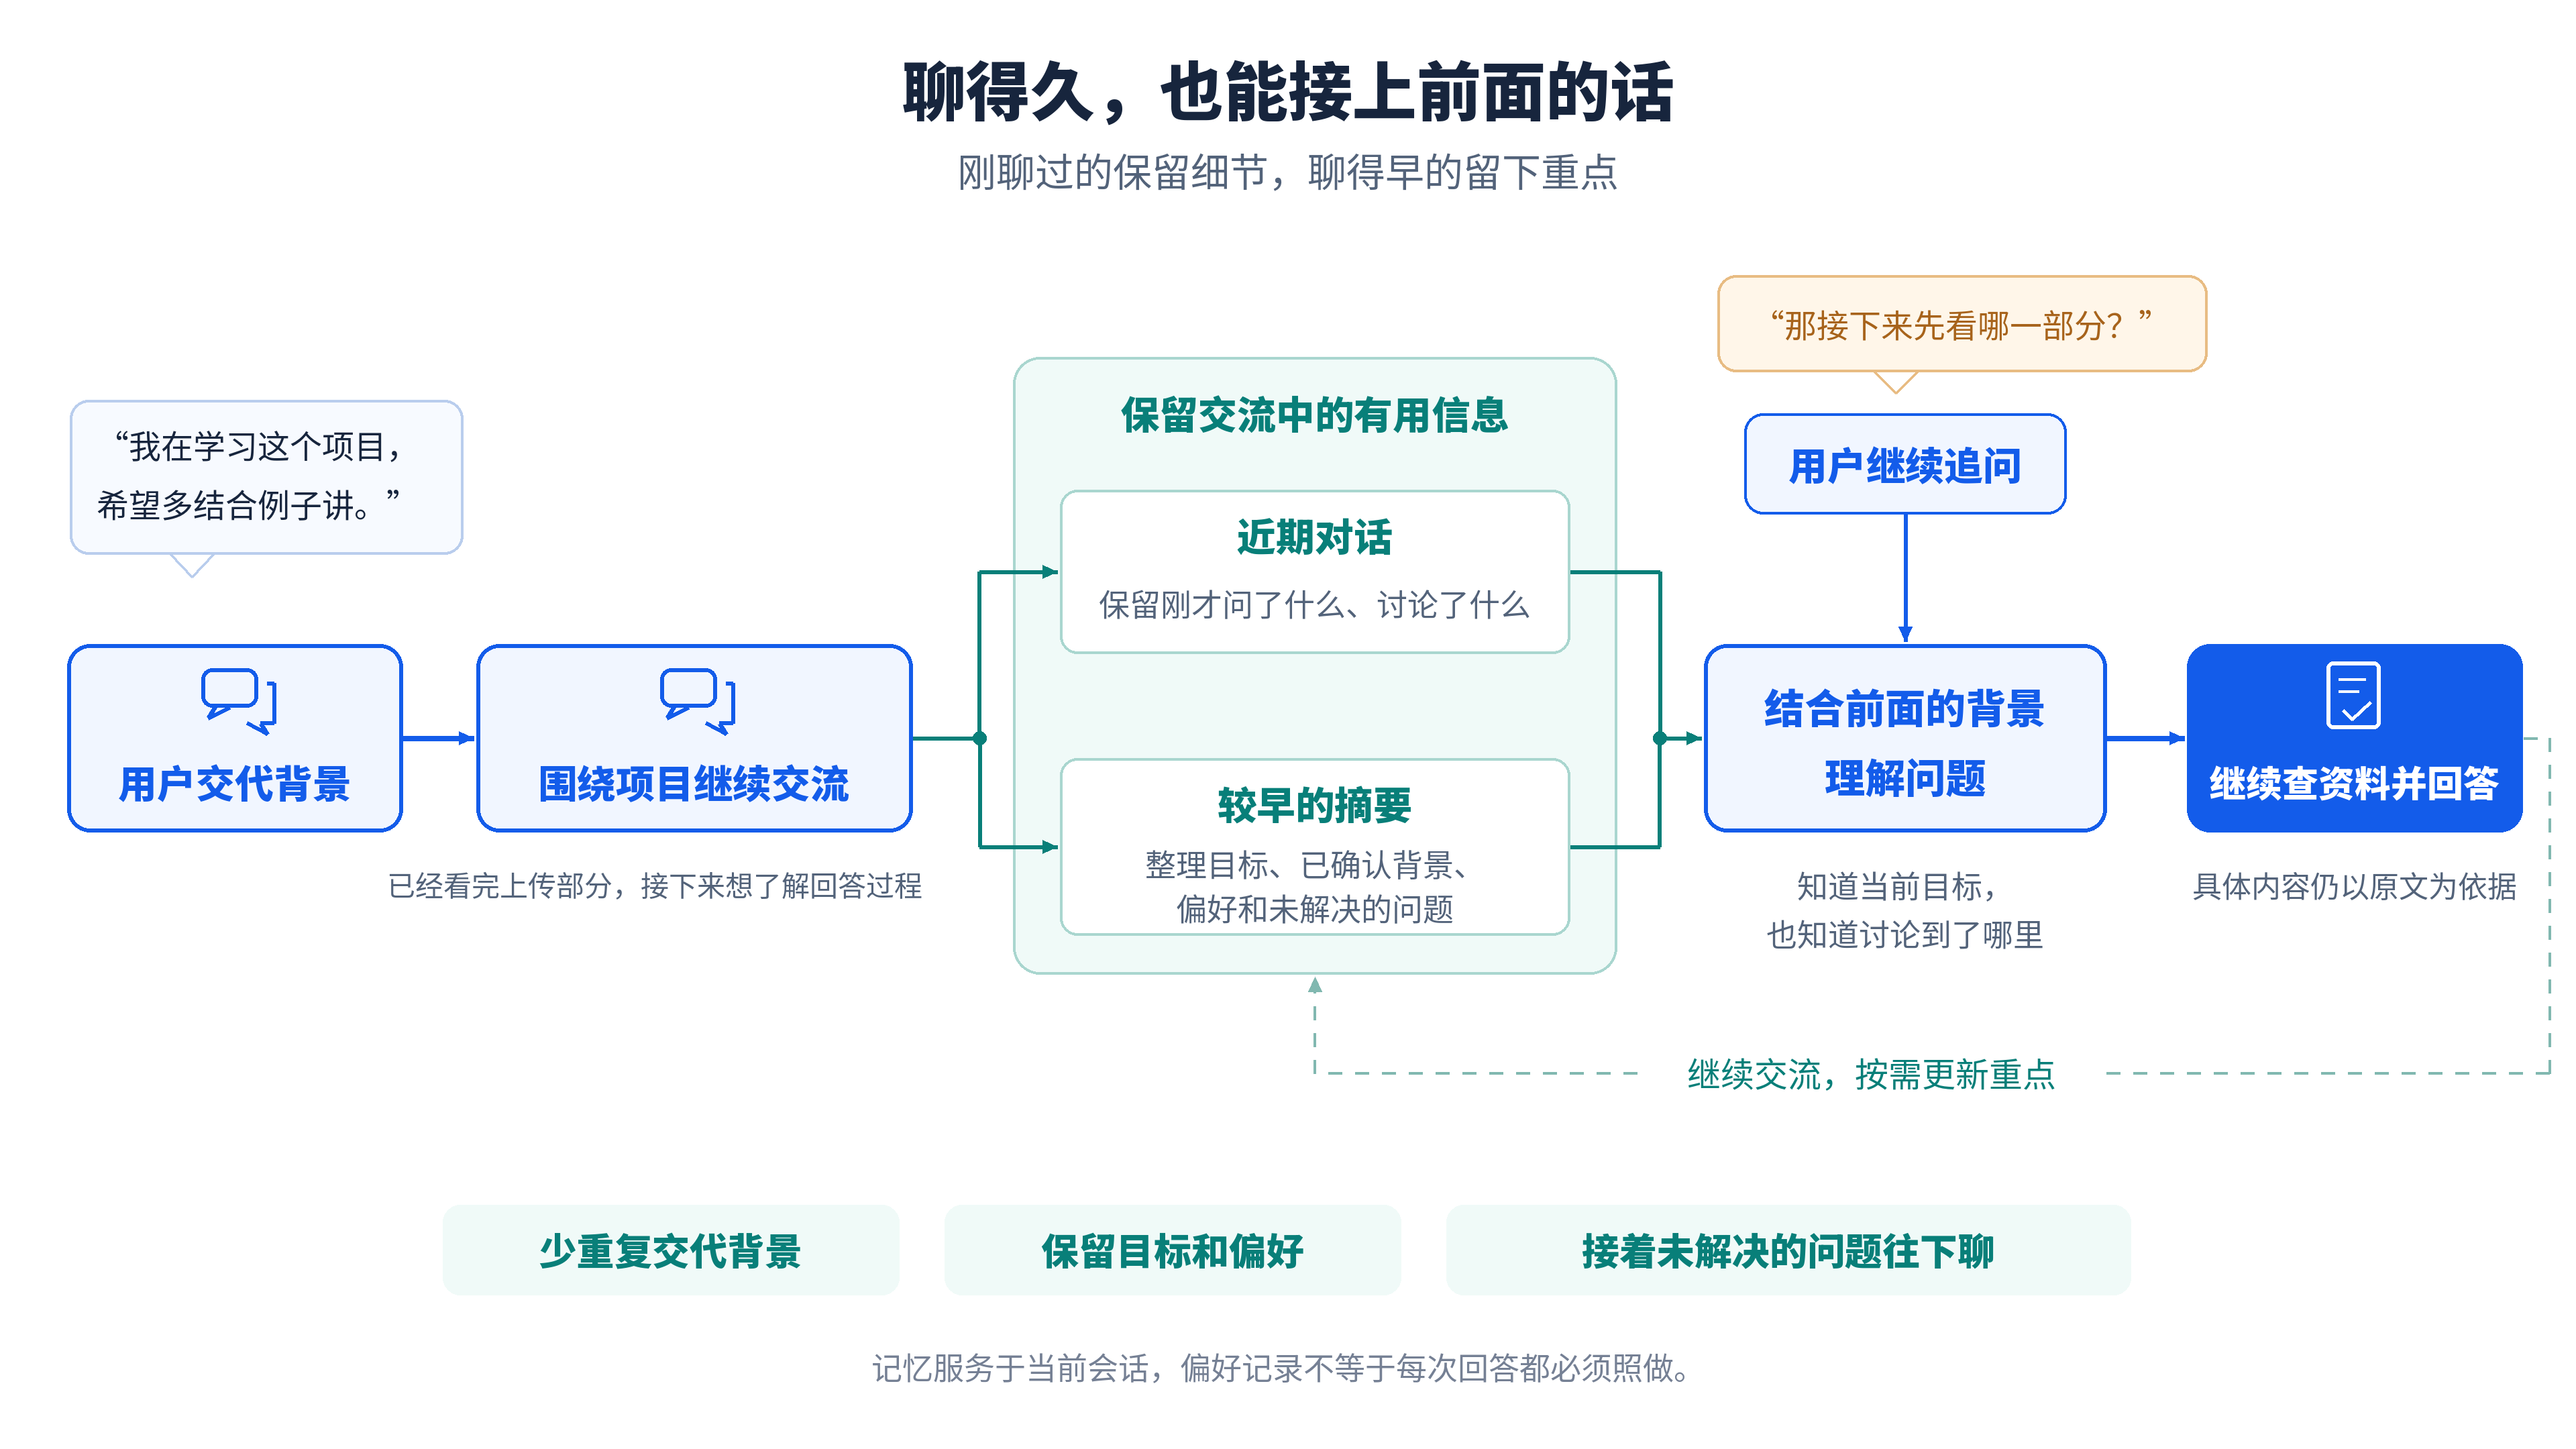
假设你正在让 AI 帮忙理解一份项目手册。前面聊了项目目标、已经完成的工作,以及目前卡住的问题。随后你问:“那接下来先看哪一部分?”
这句话单独拿出来,信息是不够的。系统需要结合前面的讨论,才能理解“接下来”指的是什么。
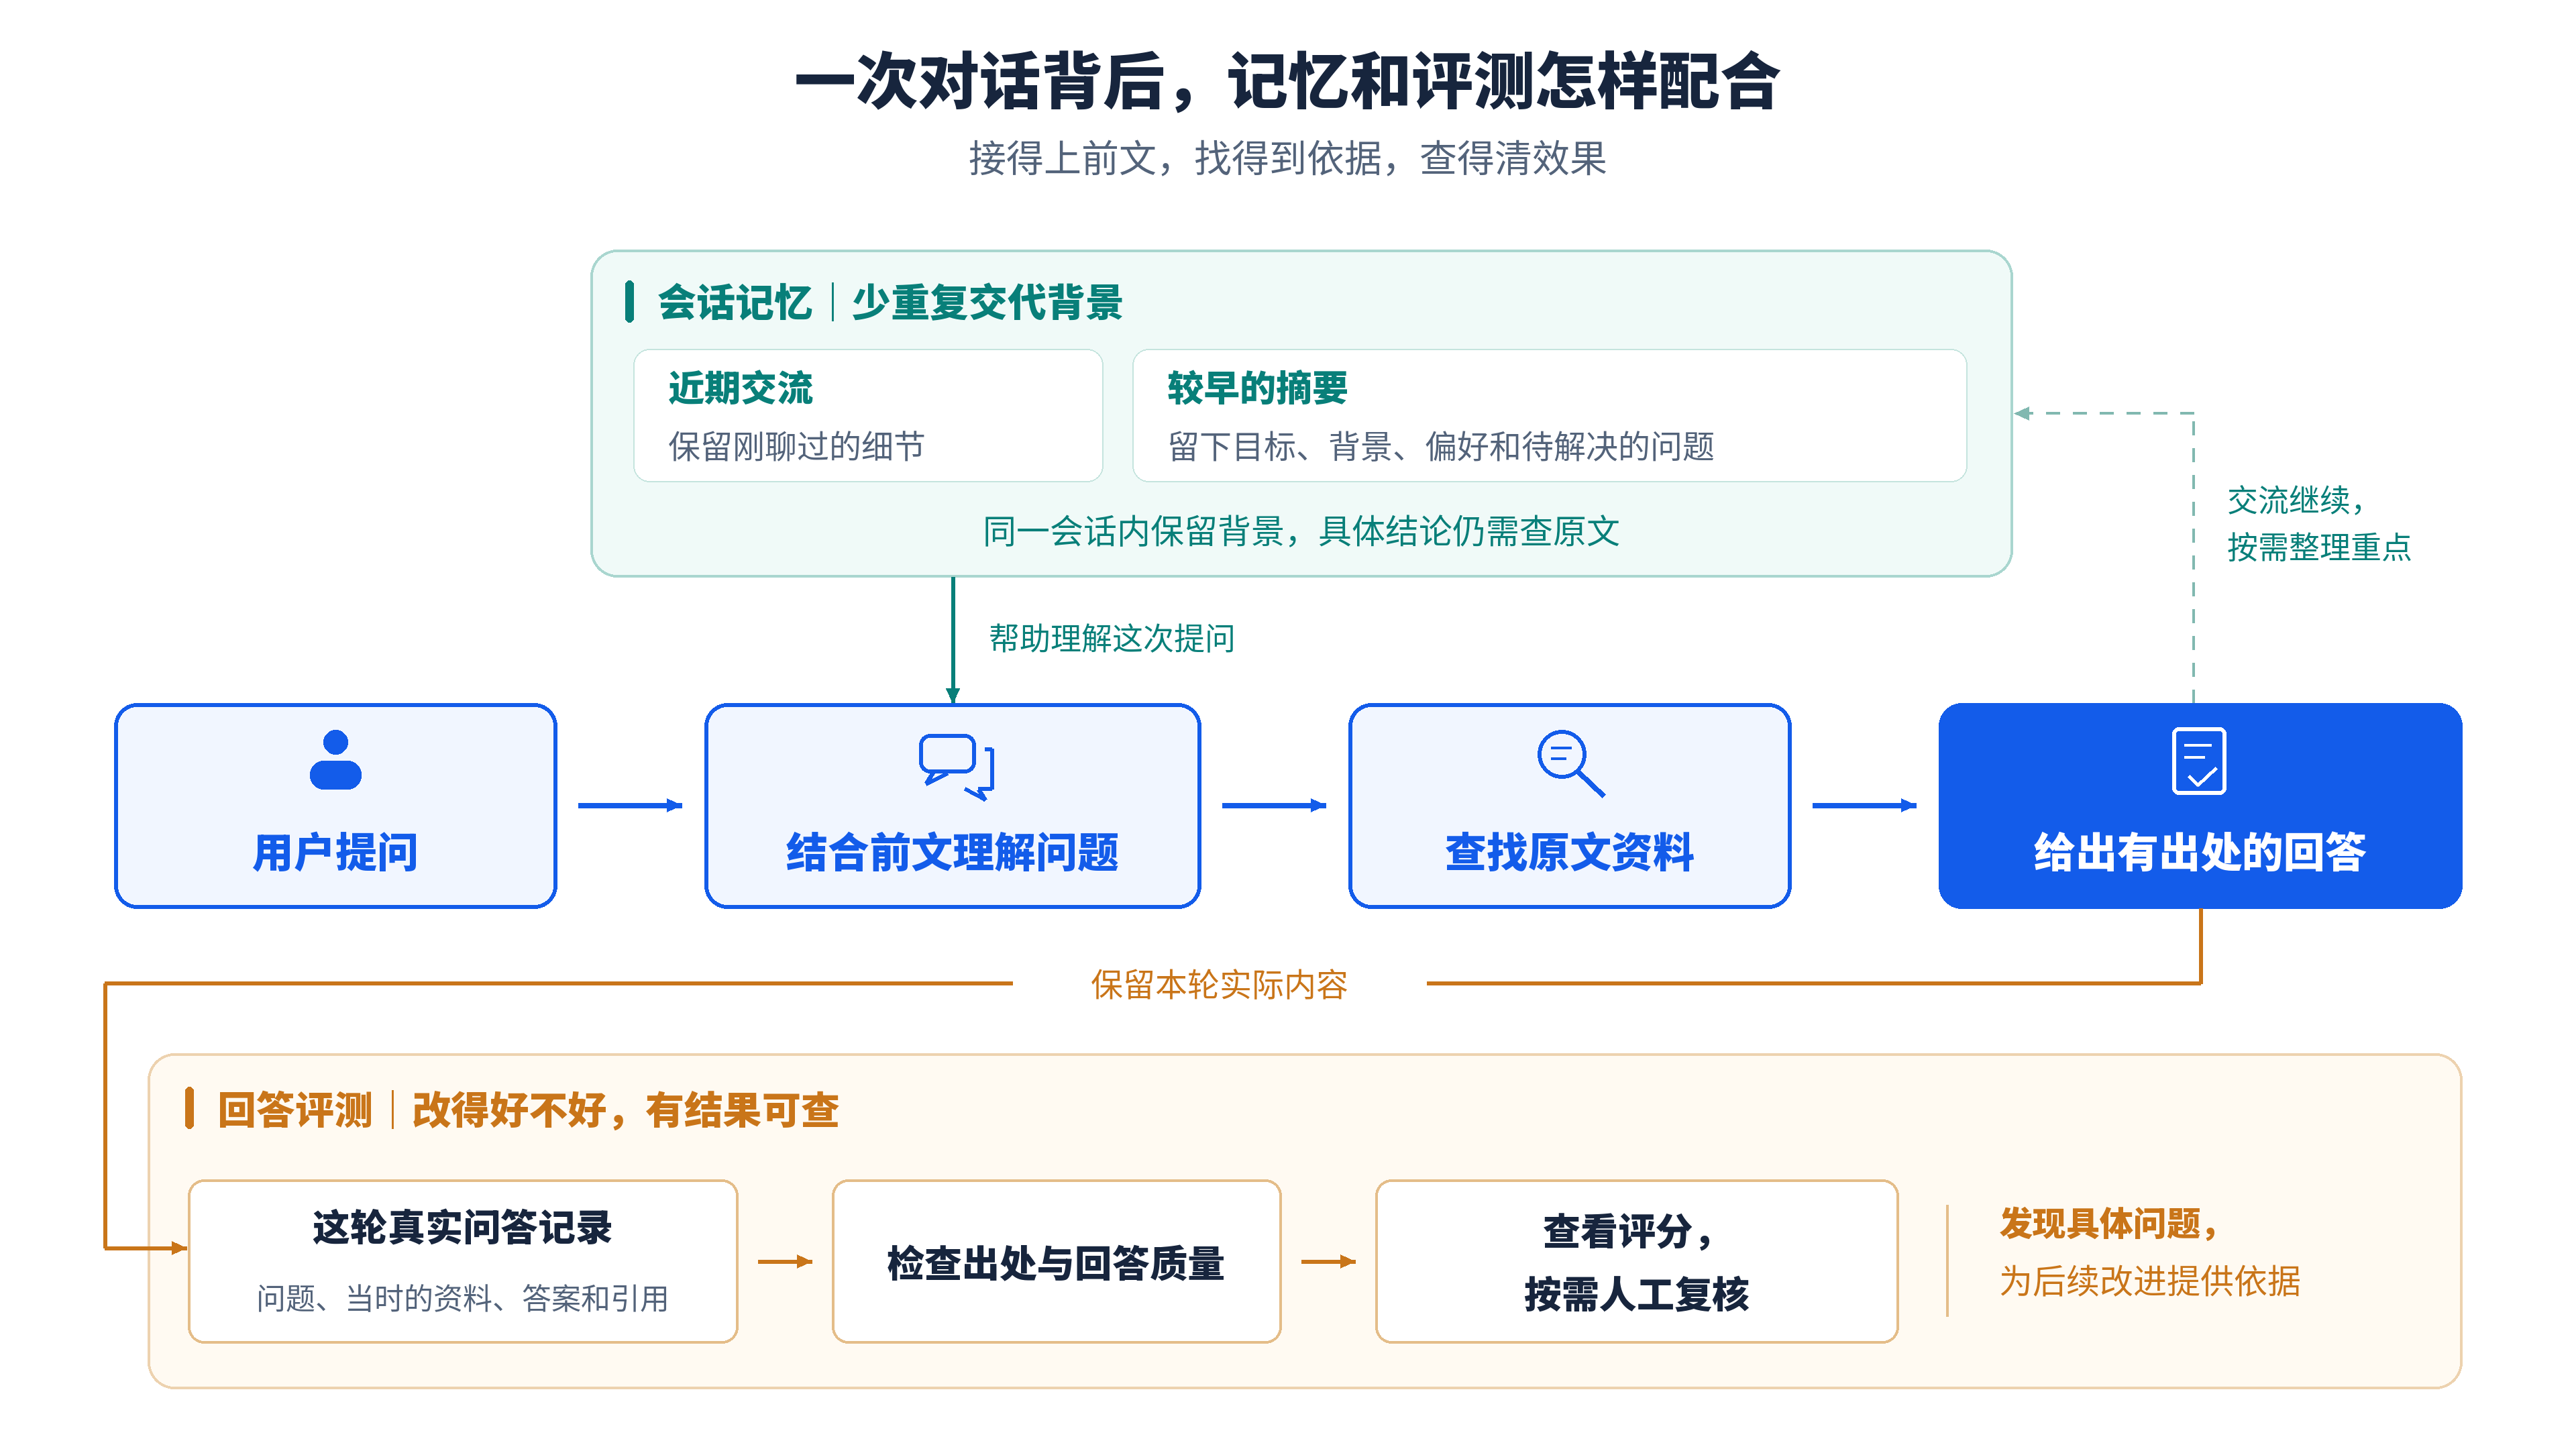
Nexus Agent Pro 会保留同一会话中的近期对话,并把较早的讨论整理成摘要。下一轮提问时,这些内容可以帮助理解用户现在的问题,减少每次从头说明的麻烦。
刚聊过的保留细节,聊得早的留下重点
对话越来越长,把所有聊天记录都原样交给模型,会占用更多空间,也会带上不少已经用不着的内容。但如果只保留最后几句话,前面确定的重要背景又容易丢失。
项目采用的是两部分配合的方式:
- 近期对话保留较多细节。 刚才问过什么、正在讨论哪一段,下一轮还可以接着理解。
- 较早的对话整理成摘要。 把目标、重要背景和待解决的问题留下,减少重复内容。
随着交流继续,新整理的内容会与已有摘要合并。摘要也会保存下来,后续继续这个会话时可以再读取,而不是只存在于一次临时请求中。
项目还提供摘要查看和重新整理的能力。需要检查系统保留了哪些重点时,有具体内容可以核对。
记下的是对话重点,不只是聊天的大概意思
摘要里会尝试分别整理几类信息:
| 保存的内容 | 对连续交流有什么帮助 |
|---|---|
| 用户正在做什么、希望达到什么目标 | 帮助后续问题围绕当前任务展开 |
| 已经确认的背景、事实和名称 | 减少反复说明同一件事 |
| 用户表达过的偏好与约束 | 为后续理解保留交流要求 |
| 已经解决的问题 | 区分哪些事情聊过了,哪些还需要继续 |
| 还没有解决的问题 | 保留下一步要跟进的方向 |
例如,一段讨论里可能既有“当前正在研究文档问答”,也有“已经看完上传部分,接下来想了解回答过程”。这些信息分别说明了目标和进度。整理时把它们保留下来,比只记一句“用户在学习项目”更有用。
用户偏好:把交流中的要求留下来
用户表达的偏好,往往夹在正常聊天里。比如“希望先看整体再看细节”“解释时多结合例子”,这些内容对理解用户的学习方式有帮助,却未必会在每一轮提问里重复出现。
Pro 版在整理会话摘要时,会尝试把这类偏好和约束单独记录下来,与当前目标、已确认背景、待跟进问题放在一起。查看摘要时,也能看到系统保留了哪些交流要求。
这样保存下来的背景就更具体了:除了知道用户在研究什么,还能留下用户希望怎样交流、有哪些要求,方便继续理解同一会话里的问题。
目前,这些偏好保存在会话中,它们是帮助理解问题的背景记录,要看是否能够帮助针对当前的问题更好的回答,所以并不是保证每次回答都照着执行。
追问时,可以接着刚才的资料往下聊
文档问答里还有一种常见情况:用户已经问过某一段内容,随后继续问“这一条适用于谁”“上一节还有什么要求”。
除了聊天内容,项目还会保留近期使用过的资料位置。识别到追问时,可以借助这些线索理解用户指的是哪份文档、哪个章节或哪段内容,再继续寻找依据。
这让交流更接近日常阅读资料的过程:先了解一部分,再围绕细节追问,不需要每次都重新复制完整标题和上一轮问题。
前面聊过的内容,还要与原文依据分开
记忆能帮助系统知道“这次在问什么”,但历史回答和摘要里也可能有误解。
所以在文档问答中,具体结论仍然需要从当前允许使用的资料中寻找依据。上一轮说过某个结论,不会因此自动变成这一轮的原文证明。
这一点也是会话记忆值得学习的地方:既要保留交流的连续性,也要避免前面的误解一轮接一轮传下去。
回答质量评测:改得好不好,要有结果可以看
项目做完以后,我们经常会继续调整:换一种找资料的方式,让模型重新比较候选内容,或者修改回答要求。
这些改动有没有效果,不能只看某一次回答是不是更长、更流畅。有时文字变好看了,重要条件却漏掉了;有时答案结论没变,但已经找到了更准确的原文依据。
Nexus Agent Pro 配套提供了独立的评测工程,可以保存真实问答,检查使用过的资料和回答结果,再结合自动评分、人工复核做对照。
小伙伴不仅能学习怎样让系统回答,还能学习怎样判断它回答得怎么样。
先留下这一次回答真正用过的材料
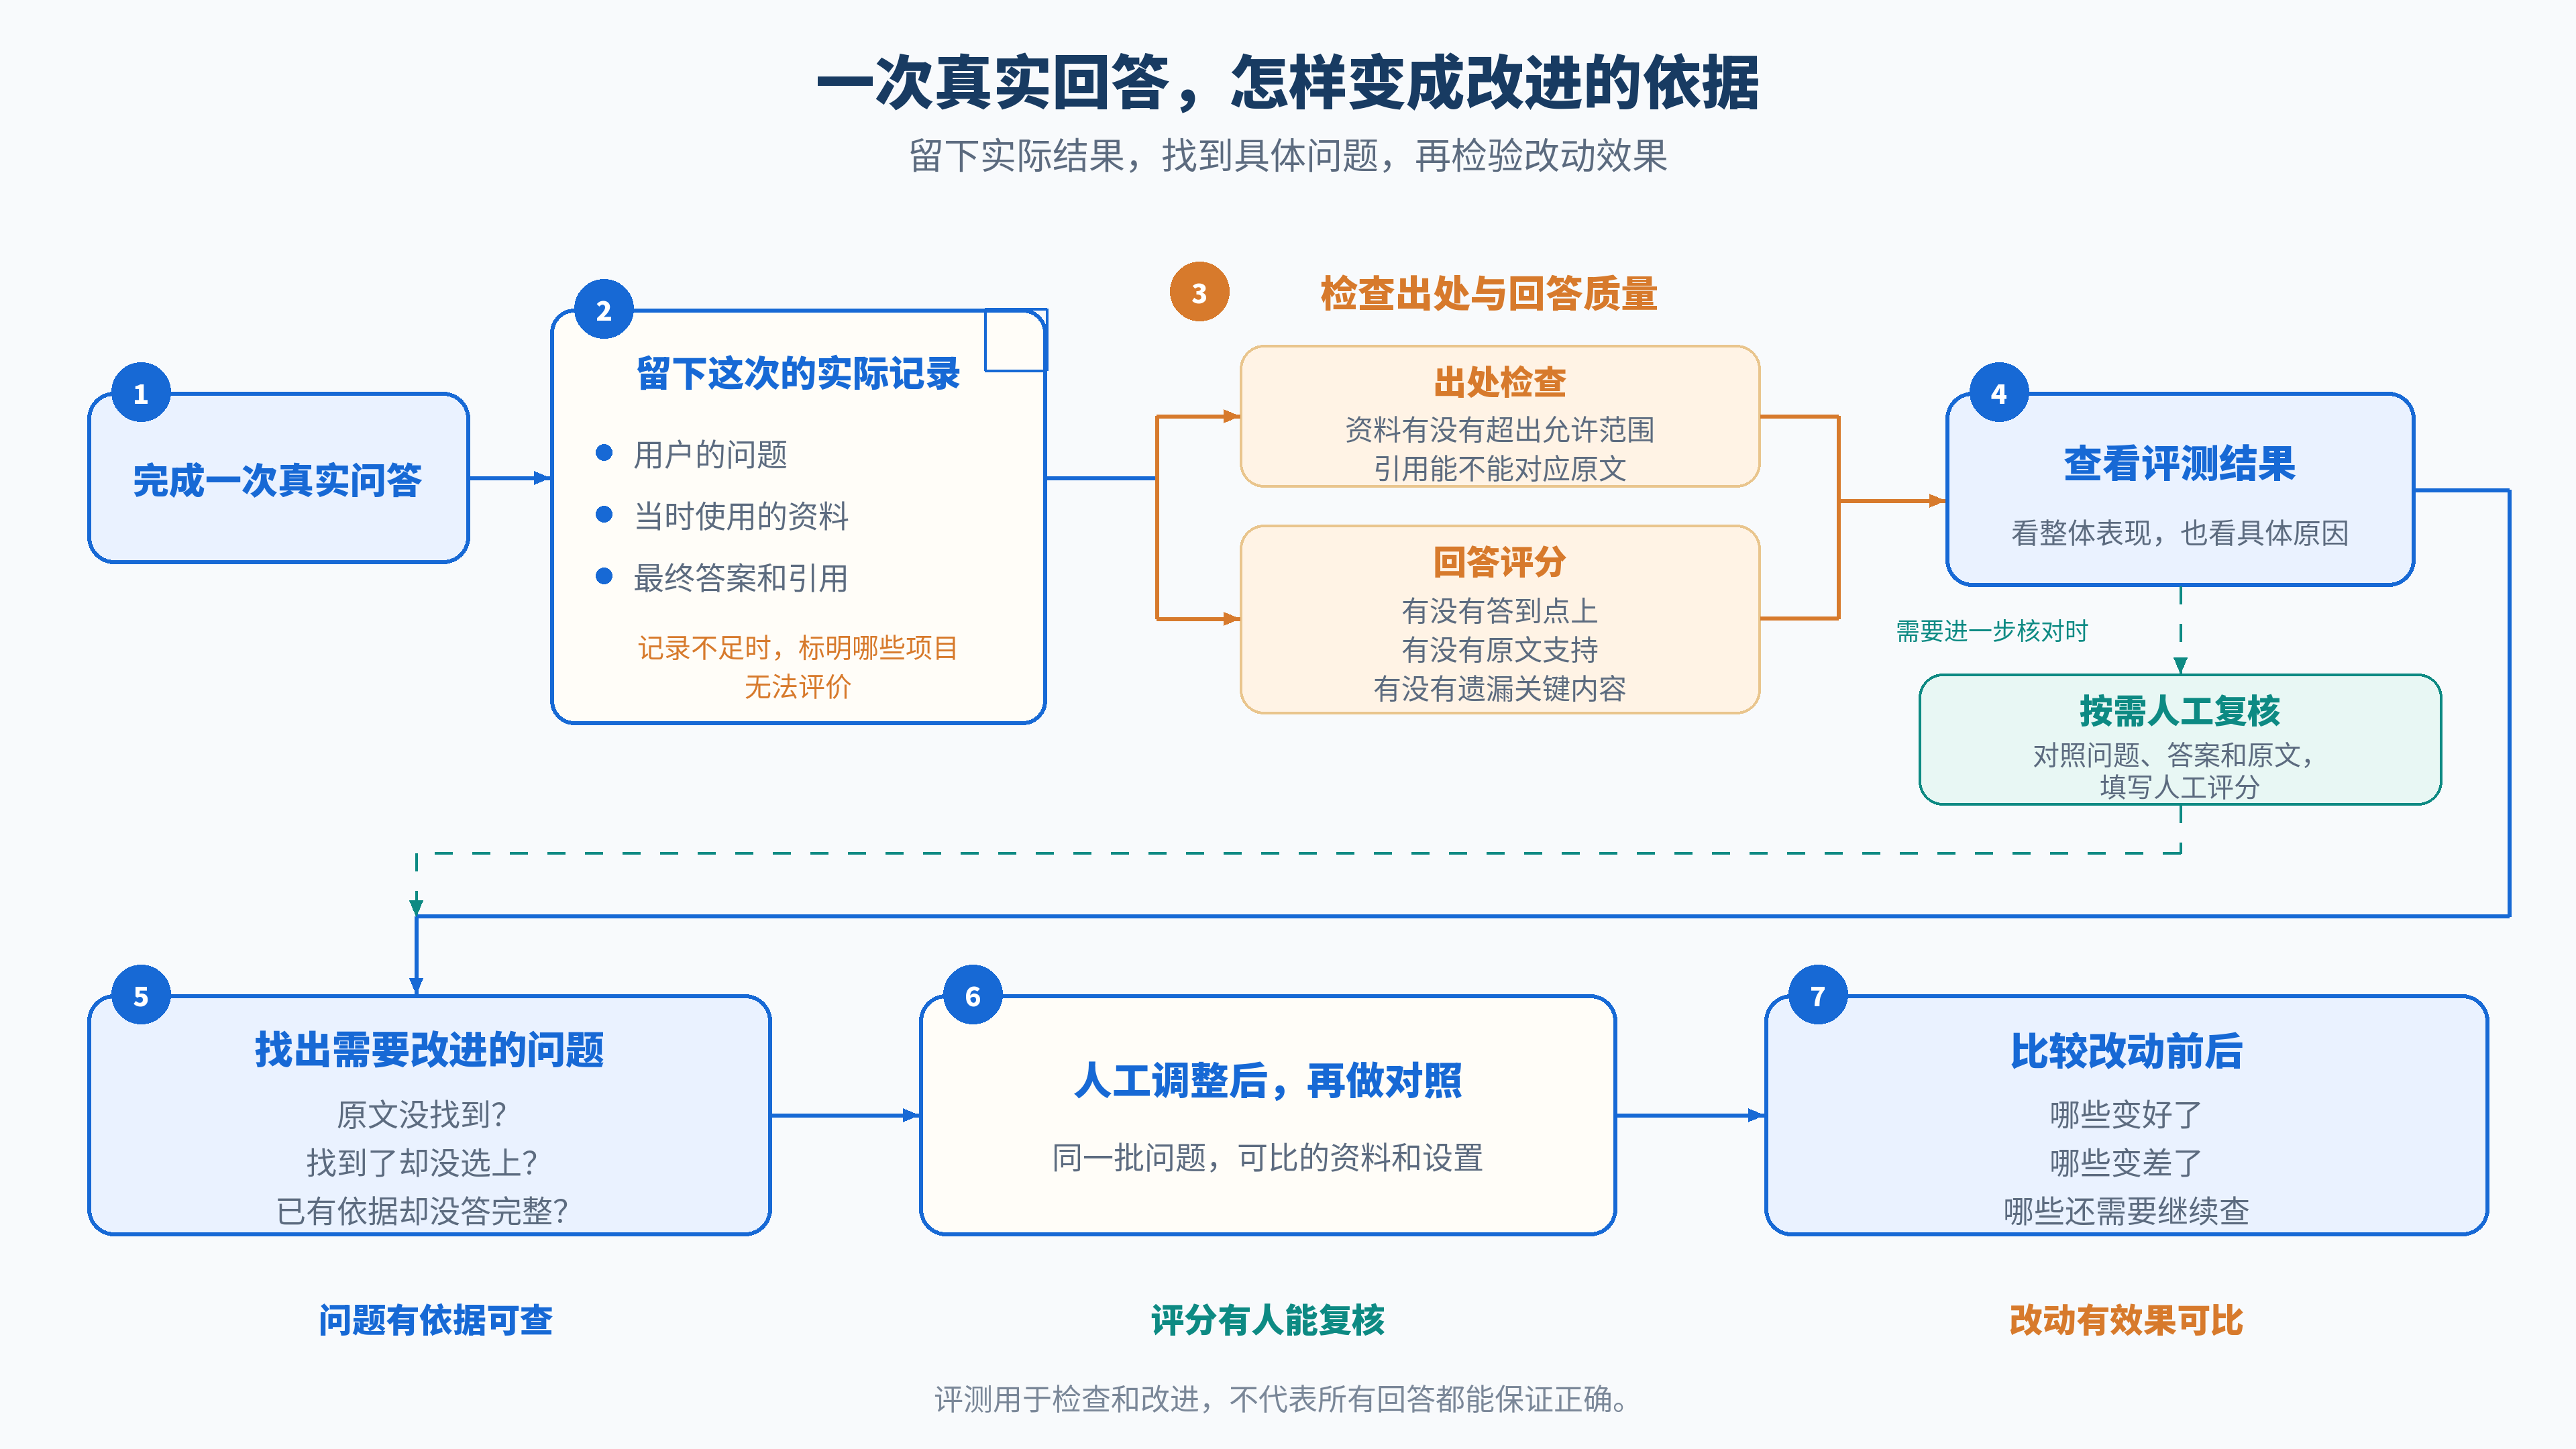
评测从一次真实问答开始。系统可以导出当时的问题、找到的材料、最终交给模型的依据、答案、引用,以及相关处理记录。
这样,后续分析就有了共同的基础。发现回答遗漏了某个条件,可以回头看:当时有没有找到那段原文?找到以后有没有被选中?还是材料已经交给了模型,回答时却没有表达出来?
这些情况需要调整的位置不同。把当次过程保留下来,就能沿着事实继续检查,减少凭感觉反复改参数。
评测使用的是这一次回答实际留下的内容。如果所需记录不完整,会说明哪些项目无法评价,不会重新找一批资料来替代当时的结果。
分开检查出处和回答内容
一个回答需要从几个角度来看:
| 检查方向 | 具体看什么 |
|---|---|
| 使用的资料范围 | 有没有跑到本次允许范围之外找答案 |
| 引用与保存的出处 | 引用能不能对应到这次实际使用的原文,前后记录是否一致 |
| 找到的内容是否相关 | 材料有没有真正围绕用户的问题 |
| 回答是否忠于资料 | 有没有把原文没有说的内容当成确定结论 |
| 关键内容是否遗漏 | 条件、例外和重要步骤有没有交代完整 |
其中,范围和出处对应等内容可以按明确规则检查;相关程度、回答是否完整等内容,可以借助模型评分,再结合人工复核。
把这些结果分开看,比只报一个总分更容易定位问题。出处正确,仍然可能答非所问;回答看起来合理,也需要核对它究竟用了什么依据。
自动评分以后,还能逐条人工复核
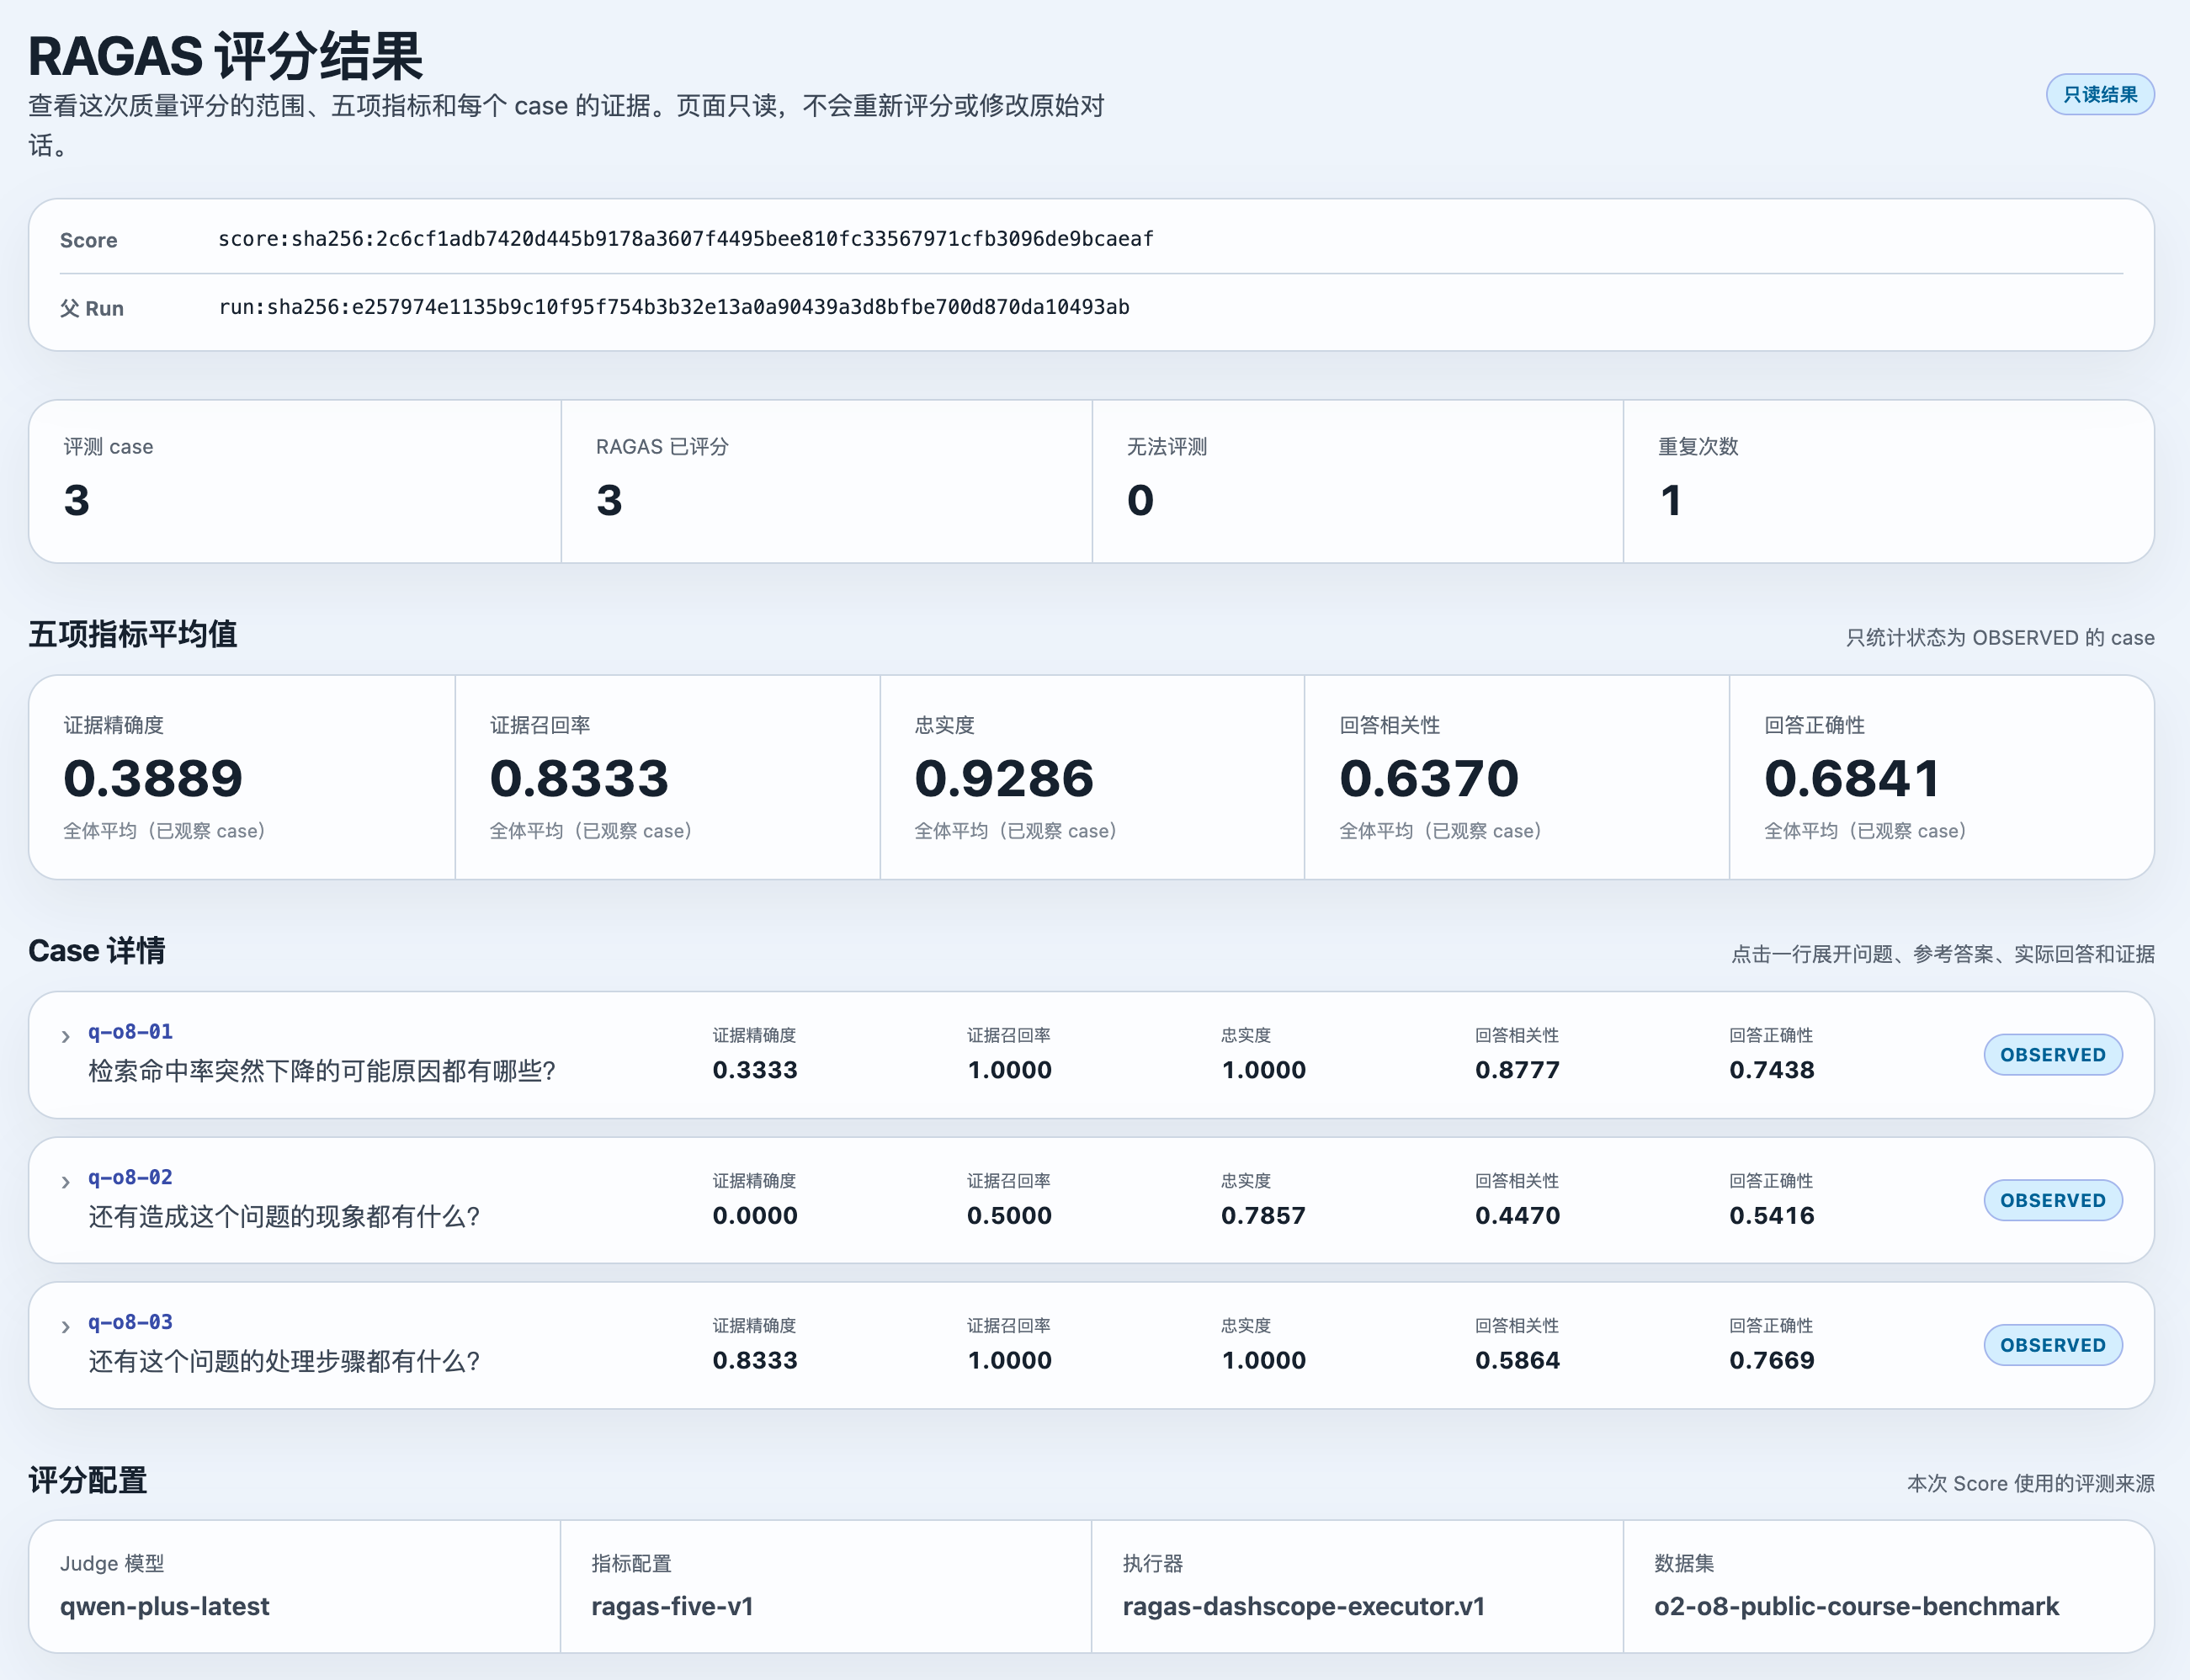
自动评分可以帮助我们先检查一批问题,但评分模型本身也可能判断不准。
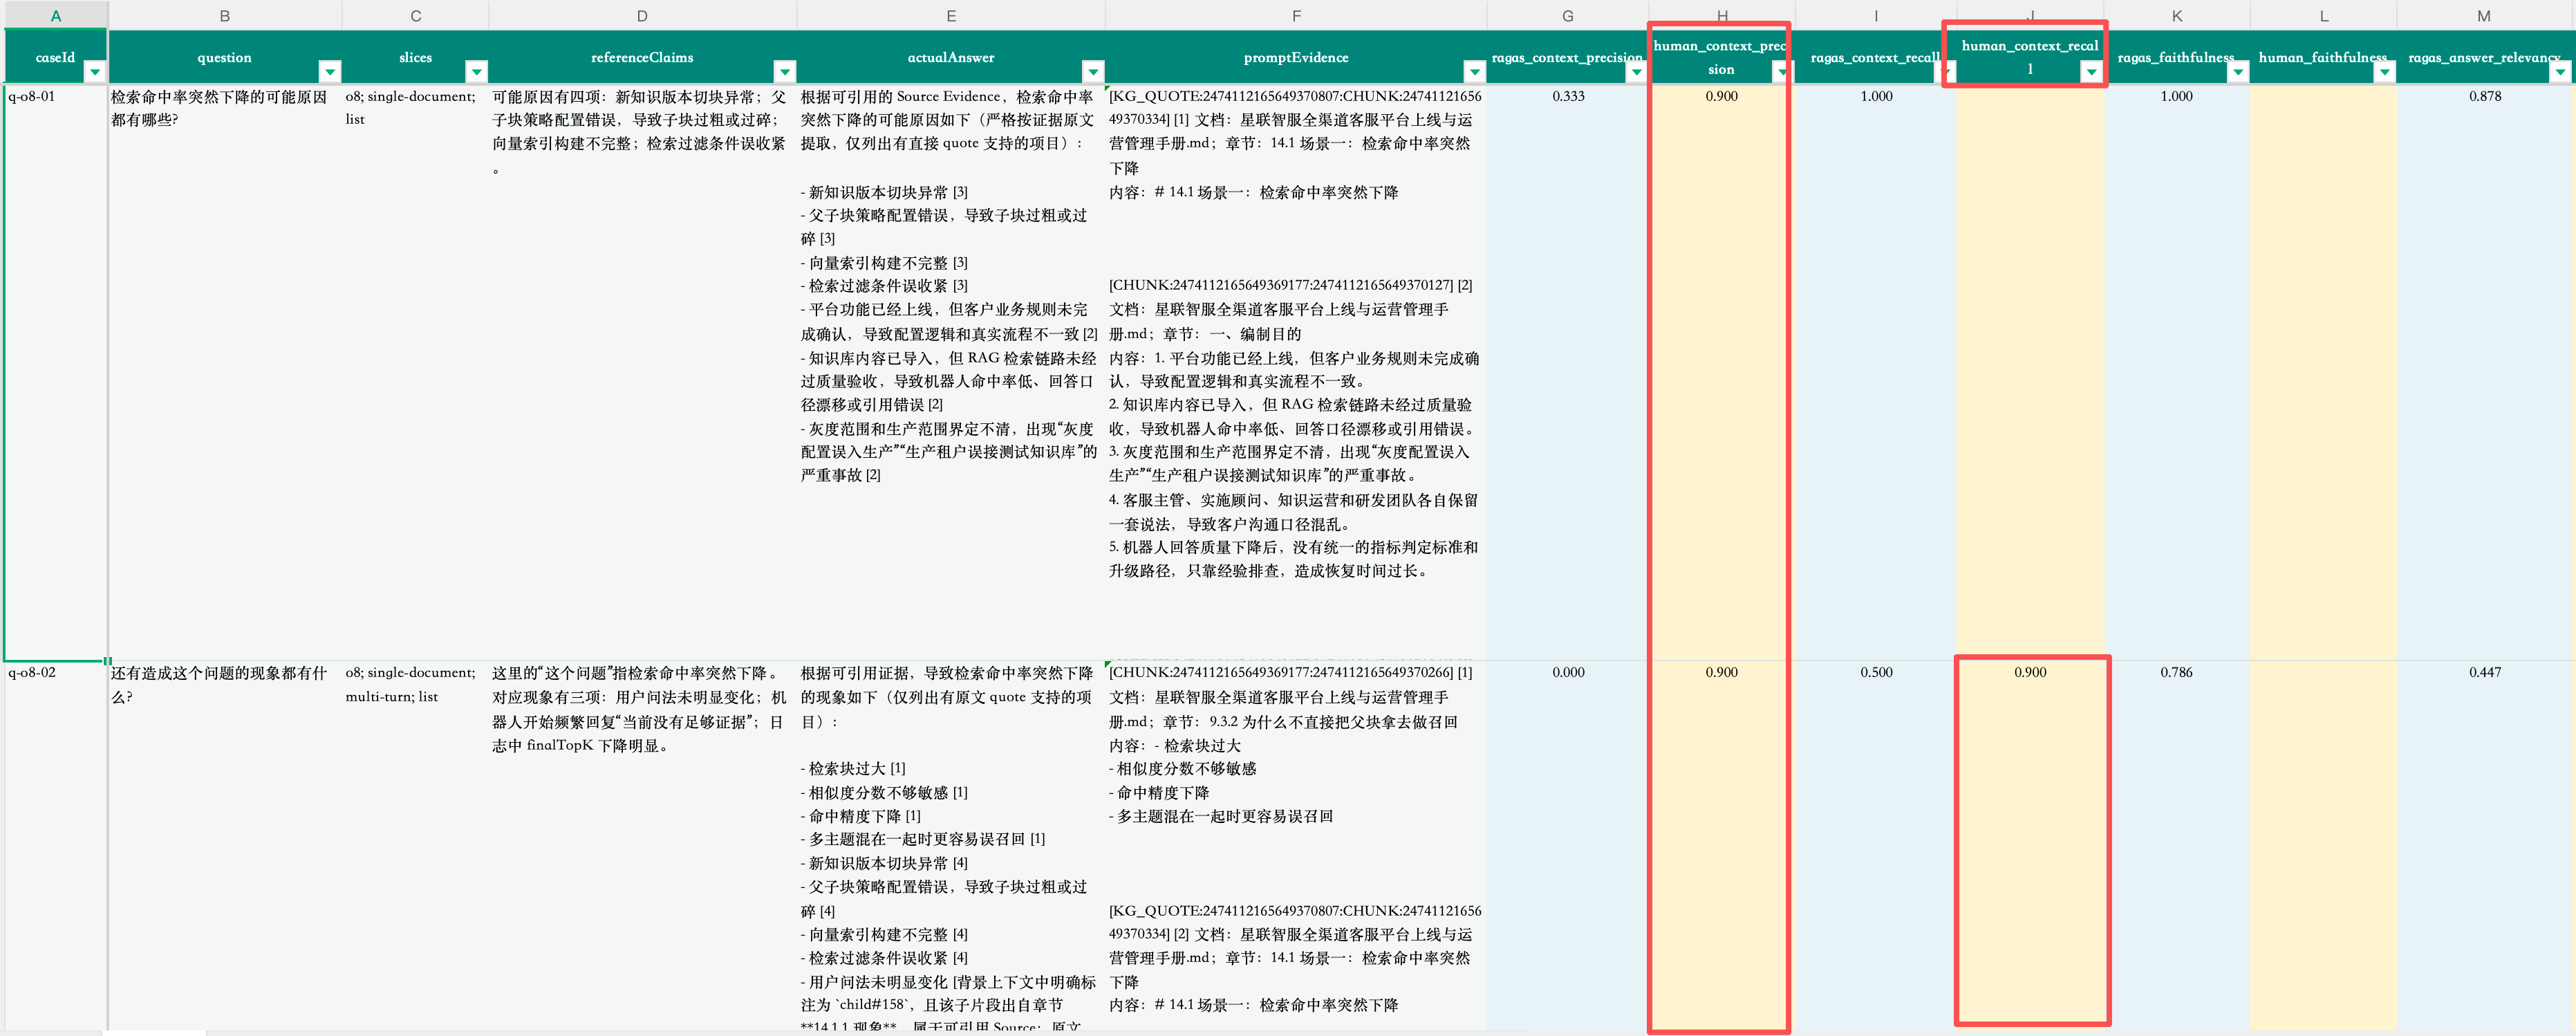
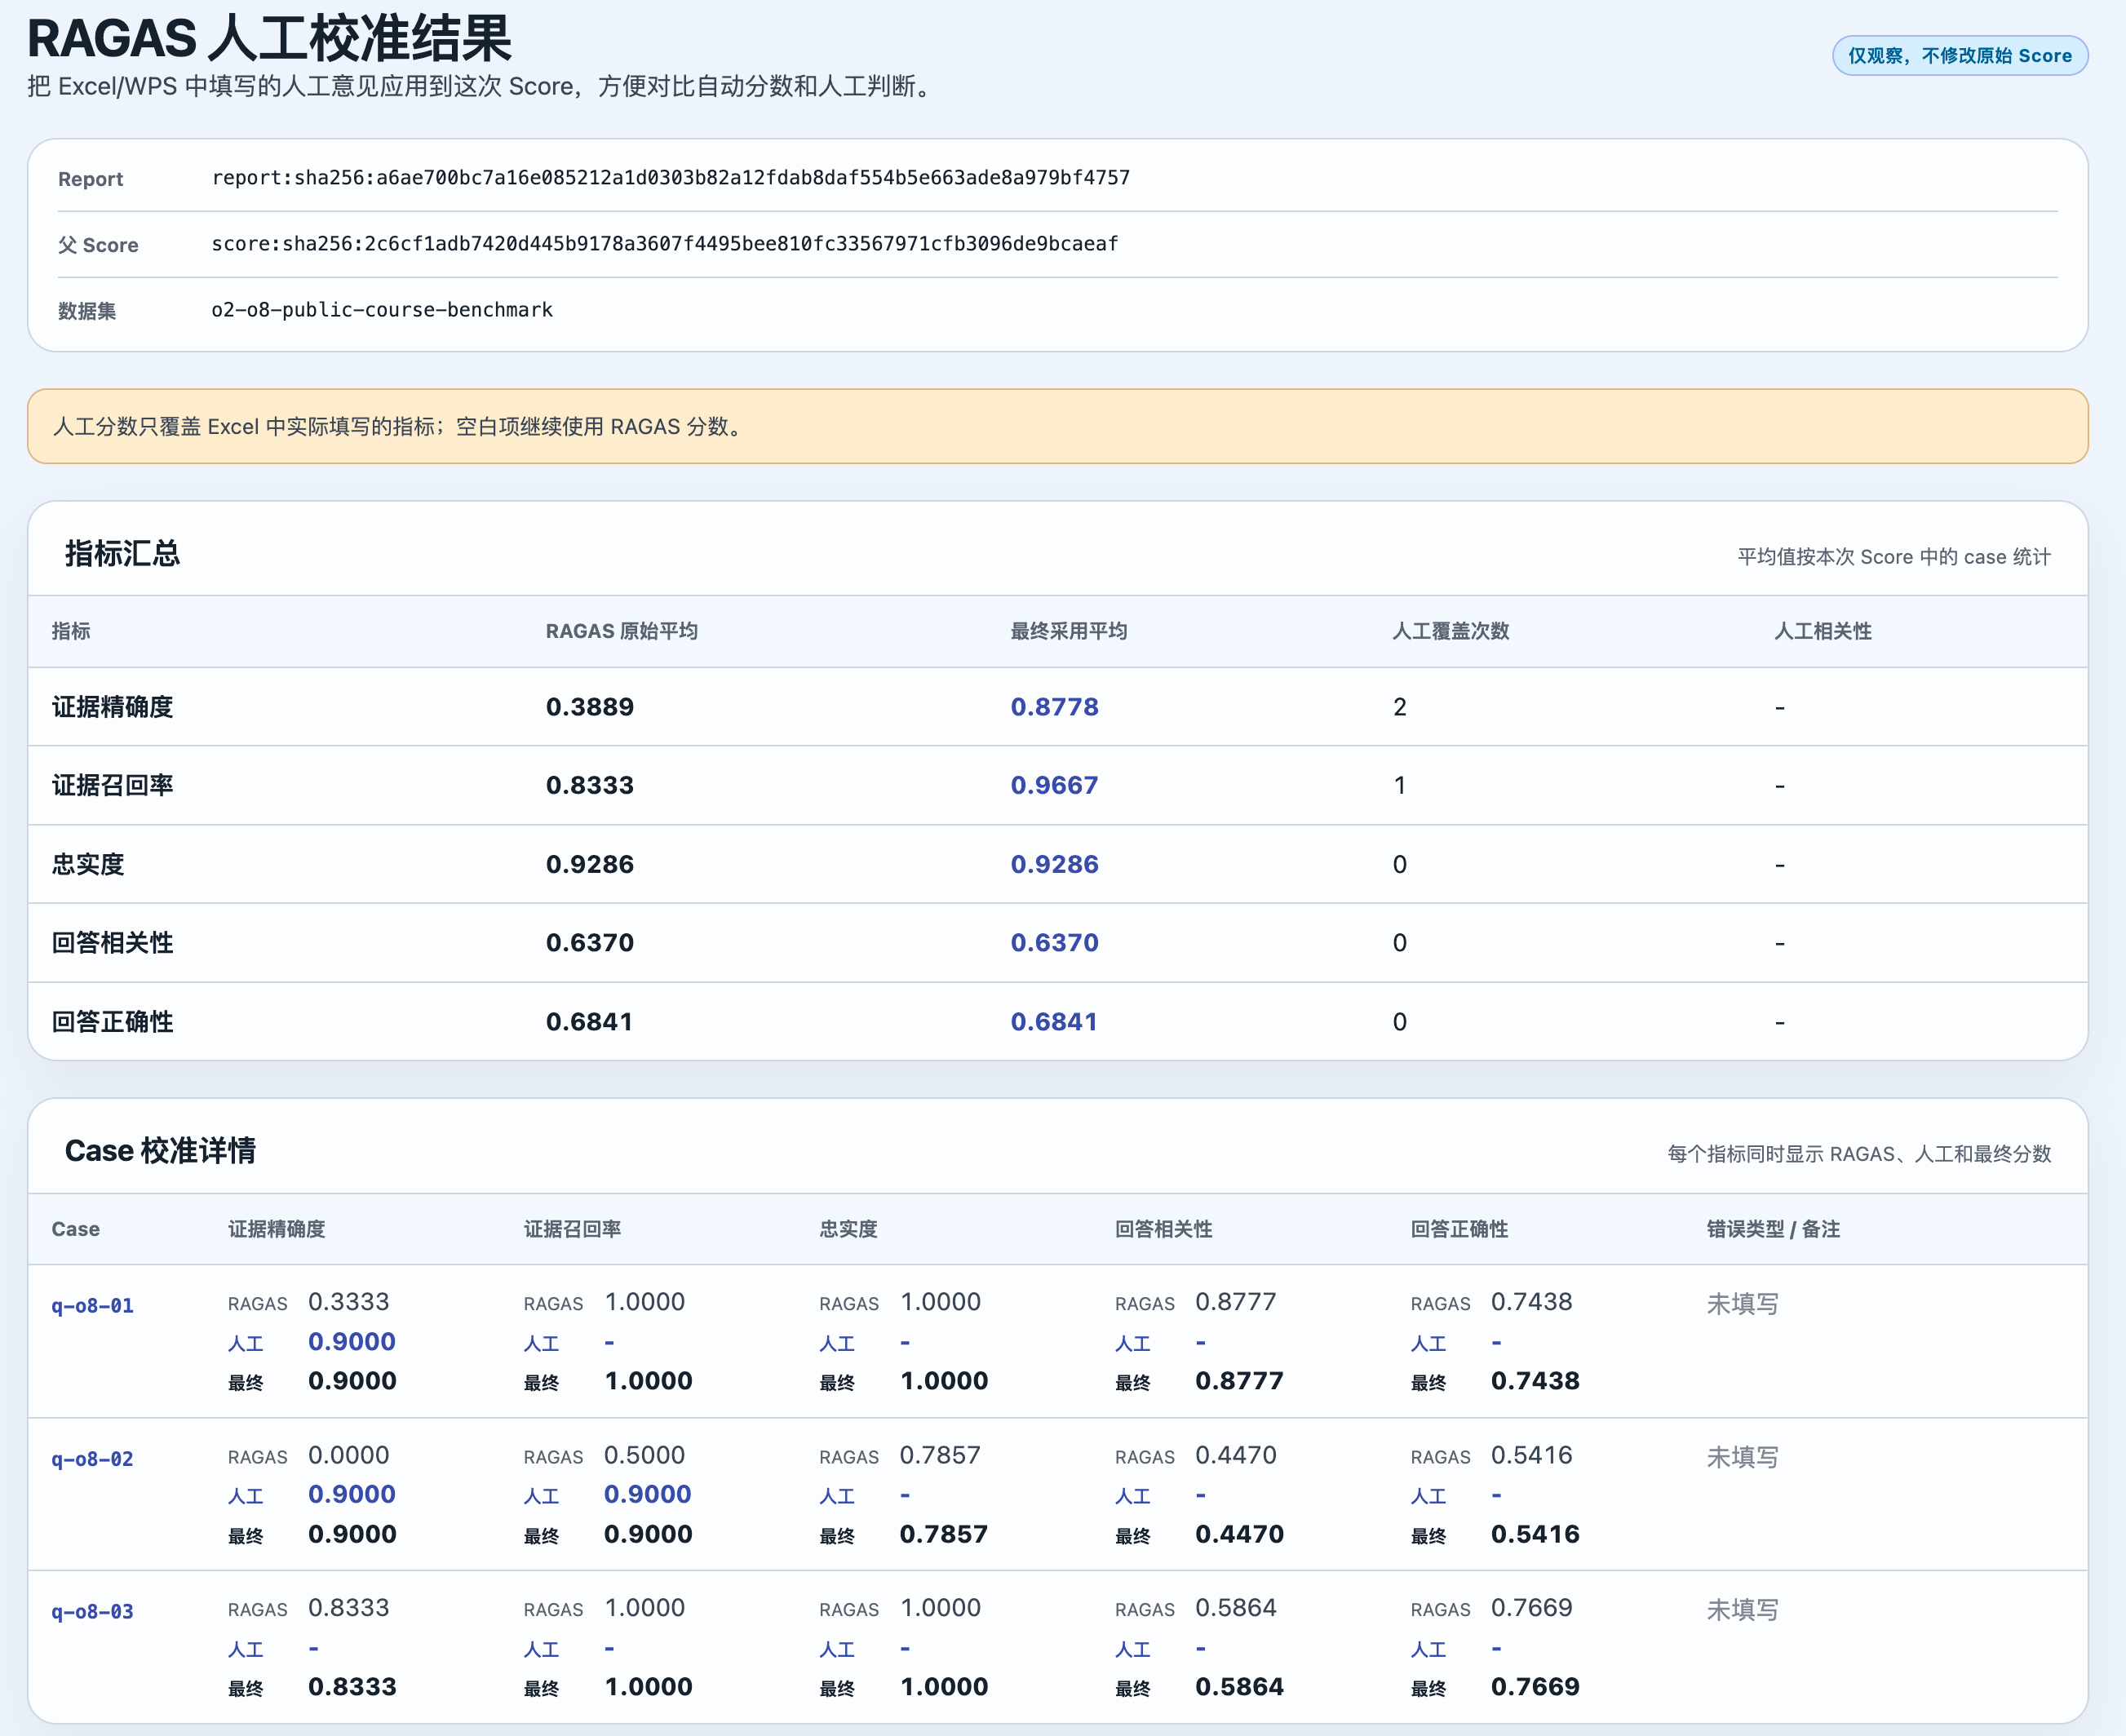
配套工具会生成可阅读的评分结果,并支持导出表格,在 Excel 或 WPS 中逐条复核。维护者可以对照问题、答案和材料,给出自己的判断,再生成结合人工评分的报告。
原始问答、原始评分和后续复核结果会分别保留。这样既能看到系统答了什么,也能比较自动评分与人工判断有哪些差异。
对学习项目的小伙伴来说,这一步很有价值:读报告时可以往下看到具体问题和依据,理解分数从哪里来,而不只是接受一个“效果很好”的结论。
用同一批问题,比较改动前后的表现
有了这些记录,就可以做有目的的对照。
比如想知道一种新的查找方式是否有帮助,可以在相同资料和可比设置下,分别保留改动前后的结果,查看原来漏掉的内容是否被找到,最终答案有没有补上关键条件。
项目也提供只比较资料查找结果的实验方式。先看两次找到了什么,再决定是否需要继续分析答案生成,排查时会更聚焦。
如果修改的是资料解析或切分方式,就需要使用重新处理后的资料来比较。否则,即使代码已经换了,问答仍可能使用旧结果,得出的判断就不可靠。
对照时可以重点观察:
- 哪些问题找到了更合适的资料;
- 哪些回答补齐了之前遗漏的内容;
- 哪些问题反而变差了,需要继续调查;
- 效果变化是否伴随着更多耗时或成本。
一次评分只能说明相应资料、模型和设置下的表现。项目提供的是可复核、可重复使用的评测方法,便于持续积累结果,而不是用几个演示问题承诺所有场景都能答对。
这两部分能给项目经历增加什么
会话记忆和质量评测,分别对应长期使用中的两类实际问题:交流能否持续,改进是否有效。
学习会话记忆,可以看到近期内容与长期摘要怎样配合,目标、偏好和待办怎样保存,以及追问怎样接上已有资料。学习质量评测,可以看到一次真实问答怎样留下证据,自动评分怎样接受人工复核,方案之间怎样做有条件、有依据的比较。
以后介绍自己的项目时,就可以结合实际案例讲清楚:为什么要保存这些记忆,哪些信息会用于下一轮理解;某次调整解决了什么问题,哪些结果证明它有帮助,还有哪些场景需要继续改进。
Nexus Agent Pro 项目的申请
Nexus Agent Pro 是我持续设计和打磨的私有项目。加入星球的小伙伴,可以结合项目源码、文档、视频和配套评测资料,学习这些能力背后的设计与实现。
还没有加入的小伙伴,可以先查看星球提供的项目、学习内容和加入方式。
已经加入的小伙伴,可以按照项目申请说明申请和学习 Nexus Agent Pro。